
De modellen kwamen thuis
Qwen, Chatterbox en Whisper draaien op onze eigen GPU-pc. Wat verandert er wanneer een AI-model een gereedschap wordt dat je zelf moet onderhouden?

Conceptuele illustratie, gemaakt met AI.
Het eerste antwoord paste in één regel: {"status":"lokaal"}.
Daarvoor waren een Docker-image, enkele gigabytes aan modelbestanden, een wachtwoord en een behoorlijke portie geduld nodig geweest. Het model stond op onze eigen computer. De berekening liep op de grafische kaart. De uitvoer kwam terug als een klein, controleerbaar bestandje.
Die ene regel was de eerste bevestiging dat de hele verbinding werkte.
Daarna volgden een Nederlandse stem en een transcriptie van die stem. Drie verschillende taken, uitgevoerd op dezelfde GPU-pc. Een werkplaats kreeg er drie soorten gereedschap bij.
Een kamer voor drie modellen
De computer heeft een RTX 3060 met 12 GB videogeheugen en ongeveer 64 GB werkgeheugen. Dat zijn de grenzen waarbinnen de inrichting moest passen. Een model dat op één grafische kaart draait, past immers niet op iedere grafische kaart. Tussen een kaart met 12 GB en een exemplaar met 96 GB ligt een heel andere werkplaats.
Voor tekst kozen we Qwen3 8B, in een vierbitsvariant. Het kan korte teksten voorbereiden, informatie ordenen en gestructureerde JSON teruggeven. In een concrete proef groepeerde het zoekwoorden over kaarsenworkshops en cadeaus en stelde het bijpassende paginatypes voor. Die taak was na ongeveer zestien seconden klaar. Dat is één meting van één opdracht, inclusief het organiseren en laden van het werk.
Chatterbox Multilingual V3 kreeg de stem. Het maakte een korte Nederlandse opname: een begroeting voor Alchemilla Levenslicht. Whisper large-v3 schreef die opname vervolgens terug naar tekst en ondertitels.
Whisper verstond de zin, maar maakte van Alchemilla het woord ‘Alchemula’.
Zo’n kleine afwijking vertelt meer over de praktische plek van AI dan een algemene belofte over nauwkeurigheid. De verbinding werkt. De betekenis vraagt nog aandacht. Een eigennaam blijft iets waarvoor iemand moet luisteren.
Ook lokaal kan een onderdeel ontbreken
De eerste transcriptiepoging mislukte. De container kon een benodigde CUDA-bibliotheek niet vinden. De software was geïnstalleerd, de GPU was zichtbaar en toch kwam er geen transcript.
De oplossing zat in de configuratie: het juiste bibliotheekpad beschikbaar maken en de container opnieuw opbouwen. Daarna slaagde dezelfde soort taak op de GPU.
Dat onderhoud hoort bij lokaal werken. Een clouddienst bergt zulke details grotendeels achter een interface op. Op een eigen machine worden de lagen zichtbaar: model, runtime, driver, bestandspad, geheugen. Je krijgt meer invloed op die lagen en wordt ook verantwoordelijk voor hun samenhang.
Er zit iets nuchters in die verantwoordelijkheid. Het woord ‘lokaal’ vertelt waar een berekening plaatsvindt. De kwaliteit moet nog worden beoordeeld. De licentie moet nog bij het gebruik passen. Een update moet nog worden getest.
Geheugen is ruimte die je deelt
Tijdens de installatie hield OctaneServer ongeveer 4,5 GB videogeheugen bezet. Voor de teksttest bleef daardoor te weinig marge over. Pas nadat was bevestigd dat Octane klaar was, stopten we die server.
Een machine is een gedeelde ruimte. Een render, een taalmodel en een videoworkflow hebben ieder hun eigen ritme, terwijl ze aanspraak maken op hetzelfde geheugen.
Daarom krijgen de lokale modeltaken een wachtrij. Die controleert vóór iedere taak de GPU en de ComfyUI-queue. Na afloop geven de modellen hun geheugen weer vrij. Dat helpt het samenleven van de toepassingen, al is het geen volledige vergrendeling: iemand kan ondertussen elders alsnog een zware render starten.
Die grens blijft zichtbaar. De mens plant het werk mee.
Een workflow die ergens eindigt
Daarna verbonden we n8n op ServerMain met de modellen op de GPU-pc. De model-API bleef op localhost; een private SSH-tunnel draagt de aanvragen tussen de machines over.
De eerste workflow doet iets overzichtelijks. Je voert zoekwoorden in. n8n dient één opdracht in en volgt de status van diezelfde opdracht. Aan het einde staan de clusters en paginatypes klaar om te beoordelen. De workflow start handmatig en plaatst zelf geen artikelen online.
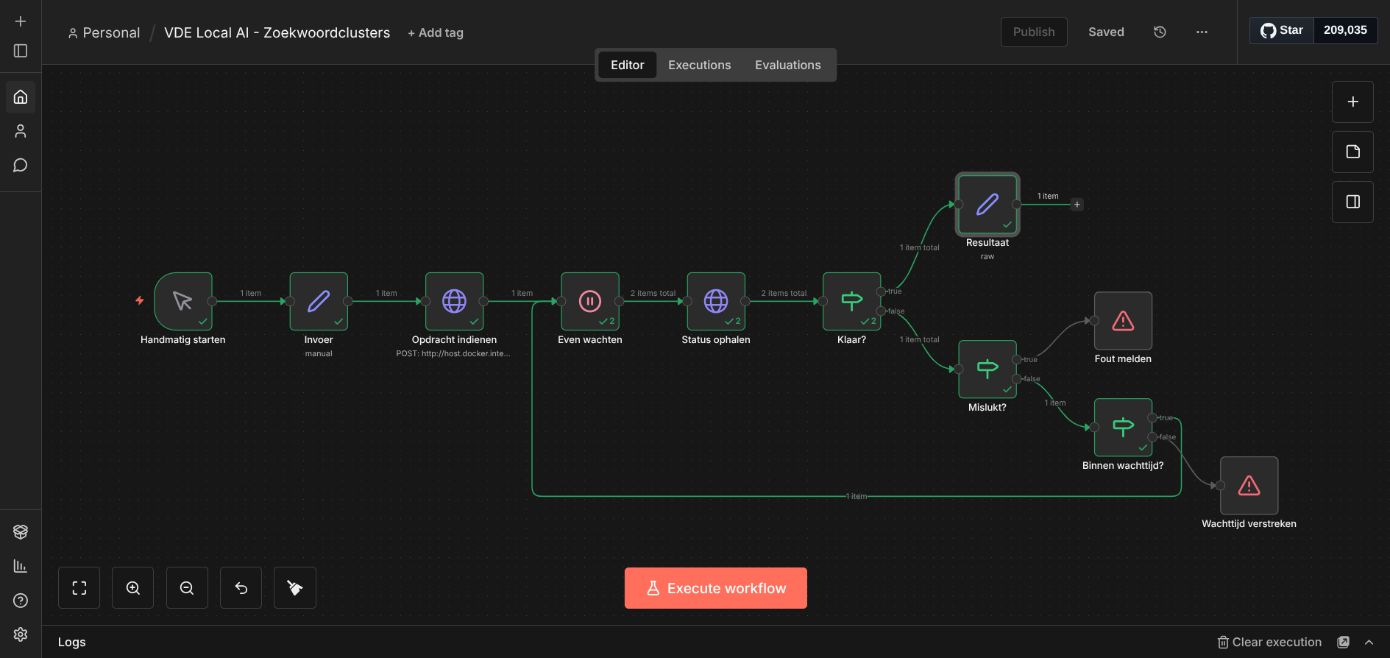
Screenshot van onze werkende n8n-workflow. De groene lijn laat zien welke stappen zijn uitgevoerd; de onderste lus volgt dezelfde modelopdracht terwijl die nog bezig is.
In Invoer staan de zoekwoorden. Opdracht indienen stuurt ze naar de lokale model-API. Even wachten en Status ophalen vormen samen de lus: ze vragen hoe het met de bestaande opdracht gaat. Zodra de status completed terugkomt, gaat de uitvoer naar Resultaat. Fouten krijgen een eigen route, zodat stilte niet ten onrechte als succes wordt behandeld.
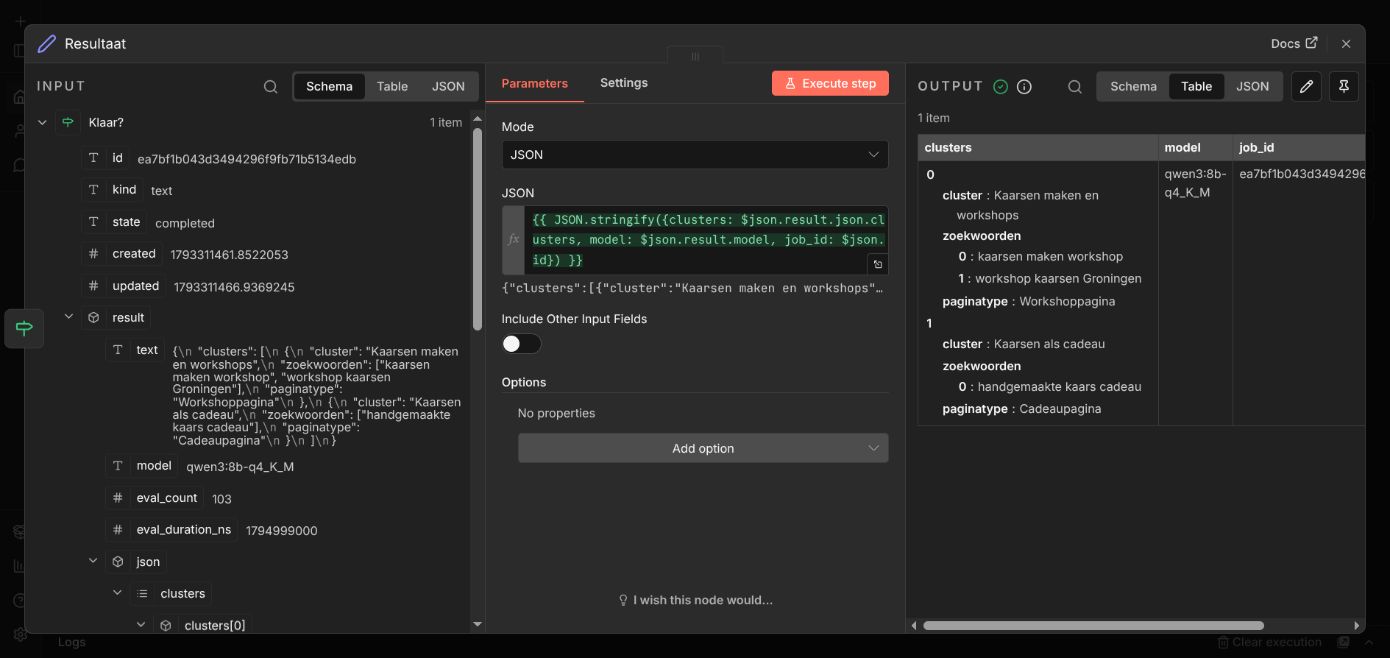
Links staat de voltooide modeltaak, in het midden de selectie van de gewenste velden en rechts de bruikbare uitvoer: clusters, paginatypes, modelnaam en job-id.
Dat laatste scherm maakt het verschil tussen een antwoord en een werkproces zichtbaar. Een tekst kan overtuigend klinken. Een vaste gegevensstructuur maakt het antwoord ook overdraagbaar naar een volgende stap. De job-id helpt om precies die ene berekening terug te vinden.
Voor de import maakten we een consistente databasebackup. Alle 125 bestaande workflows bleven behouden. Het nieuwe gereedschap moest een plaats krijgen tussen werk dat er al was.
Dat is voor mij de interessante beweging van lokale AI. Een model krijgt een concrete plek: op deze machine, met deze grenzen, voor deze taak. Het antwoord kan worden teruggevonden. Een fout kan worden onderzocht. Iemand kan besluiten wanneer het werk goed genoeg is om verder te gaan.
Op het scherm staat nog steeds dat kleine woord: lokaal.
In de praktijk betekent het dat er iemand in de buurt moet blijven.
Bronnen
- Qwen3 8B: model en licentie.
- Chatterbox: meertalige spraakmodellen.
- faster-whisper: lokale transcriptie.
- Ollama in Docker.
De beschreven uitvoer, fout en workflowcontroles komen uit onze eigen installatieproeven van 29 oktober 2026. De genoemde tijd is geen algemene benchmark.